Chọn đến phần học sinh cần nhanh chóng thông qua mục lục bằng cách click đến phần đó
I. Lý thuyết trọng tâm
1. Tìm hiểu sơ lược về Học máy
a) Đặt vấn đề – Bộ lọc thư điện tử
Khi sử dụng thư điện tử, các em có thể thấy nhiều thư được tự động phân loại vào Hộp thư rác (Spam). Việc phân loại này được thực hiện nhờ bộ lọc thư điện tử.

Cách truyền thống: Bộ lọc thư là tập hợp các quy tắc được thiết kế để phát hiện thư rác, ví dụ:
- Nội dung hoặc tiêu đề chứa các cụm từ đáng ngờ như “miễn phí”, “giảm giá”, “rẻ bất ngờ”…
- Địa chỉ người gửi hoặc máy chủ gửi thư thuộc “danh sách đen”
Hạn chế của cách truyền thống:
- Các loại thư rác mới xuất hiện ngày càng nhiều và đa dạng
- Việc xây dựng bộ lọc bằng cách thủ công tốn nhiều công sức và không hiệu quả
Giải pháp: Sử dụng Học máy giúp máy tính tự xây dựng bộ lọc để phân loại thư điện tử.
b) Khái niệm Học máy
Định nghĩa: Học máy (Machine Learning) là một lĩnh vực của Trí tuệ nhân tạo (AI), tập trung vào việc phát triển các thuật toán và mô hình cho phép máy tính tự học và cải thiện từ dữ liệu để đưa ra dự đoán hoặc quyết định dựa trên dữ liệu mà không cần lập trình rõ ràng.
Hai điểm mấu chốt trong khái niệm Học máy:
| Điểm mấu chốt | Ý nghĩa |
|---|---|
| Máy tính tự học từ dữ liệu | Máy tính không biết trước cách giải quyết vấn đề, nó tự học từ dữ liệu được cung cấp |
| Không cần lập trình rõ ràng | Không cần viết chương trình hướng dẫn máy tính các quy tắc cụ thể |
c) Ví dụ minh họa hai điểm mấu chốt
Ví dụ 1: Lọc thư điện tử
| Cách lập trình truyền thống | Cách Học máy |
|---|---|
| Viết quy tắc: “Thư chứa từ X hoặc Y là thư rác” | Cung cấp tập dữ liệu các ví dụ về thư rác và thư hợp lệ |
| Phải liệt kê tất cả các trường hợp | Máy tính tự học những đặc điểm, mẫu hoặc quy luật |
| Không thể bao quát hết các tình huống mới | Máy tính tự sử dụng để đoán nhận và phân loại thư mới |
Ví dụ 2: Nhận dạng con ngựa trong hình ảnh
| Cách lập trình truyền thống | Cách Học máy |
|---|---|
| Mô tả: “Con vật có 4 chân cao, mặt dài, đôi tai nhọn là con ngựa” | Cung cấp hàng nghìn hình ảnh chứa con ngựa và các con vật khác |
| Việc mô tả tất cả đặc điểm trong mọi trường hợp là không khả thi | Máy tính tự xác định các đặc trưng từ dữ liệu |
| Không hiệu quả | Máy tính sử dụng các đặc trưng đã học để nhận dạng ngựa trong hình ảnh mới |
Điểm chung: Trong cả hai ví dụ, máy tính không biết trước như thế nào là thư rác hoặc như thế nào là con ngựa – nó tự học từ dữ liệu mà chúng ta cung cấp. Đây là điểm mấu chốt nhất trong tất cả các ứng dụng Học máy.
d) Quy trình Học máy
Việc xây dựng các ứng dụng Học máy được chia thành 5 bước cơ bản:
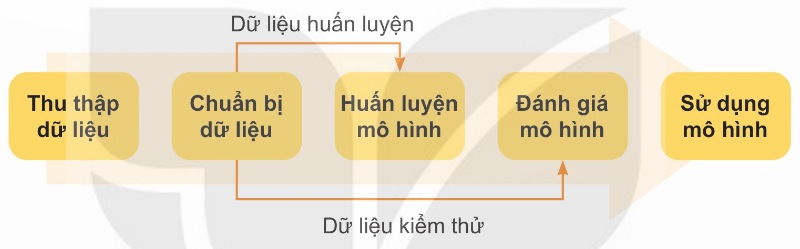
Bước 1: Thu thập dữ liệu
- Lấy dữ liệu từ nhiều nguồn: cơ sở dữ liệu, tệp tin, ghi chép trực tiếp
- Tùy theo bài toán cần giải quyết mà chọn nguồn dữ liệu phù hợp
Bước 2: Chuẩn bị dữ liệu (Làm sạch dữ liệu)
- Loại bỏ dữ liệu nhiễu
- Bổ sung các giá trị thiếu
- Chuyển đổi dữ liệu sang định dạng phù hợp
- Giảm kích thước dữ liệu nếu cần
Lưu ý quan trọng: Bước 1 và 2 là hai bước quan trọng nhất, chiếm nhiều thời gian và công sức nhất của quá trình xây dựng ứng dụng Học máy. Hai bước này có thể phải thực hiện lặp đi lặp lại cho tới khi thu được bộ dữ liệu như mong muốn.
Phân chia dữ liệu:
| Loại dữ liệu | Tỷ lệ | Mục đích |
|---|---|---|
| Dữ liệu huấn luyện | 70% – 80% | Dùng để huấn luyện mô hình |
| Dữ liệu kiểm thử | 20% – 30% | Dùng để đánh giá mô hình |
Bước 3: Huấn luyện mô hình
- Chọn thuật toán học máy phù hợp (hồi quy tuyến tính, cây quyết định, mạng nơron…)
- Thực hiện thuật toán trên tập dữ liệu huấn luyện
- Kết quả: Một mô hình Học máy để giải quyết bài toán cụ thể
Bước 4: Đánh giá mô hình
- Áp dụng mô hình trên tập dữ liệu kiểm thử
- Đánh giá hiệu suất của mô hình trong việc dự đoán dữ liệu mới
- Cải thiện mô hình nếu cần bằng cách:
- Bổ sung thêm dữ liệu huấn luyện mới
- Điều chỉnh các tham số của thuật toán
- Sử dụng các thuật toán Học máy khác
Lưu ý: Hai bước huấn luyện và đánh giá có thể được thực hiện lặp đi lặp lại cho tới khi thu được mô hình Học máy như mong muốn.
Bước 5: Sử dụng mô hình
- Sử dụng mô hình thu được để giải quyết vấn đề đặt ra
- Thực hiện dự đoán hay phân cụm trên dữ liệu mới
2. Phân loại và vai trò của Học máy trong thực tế
a) Phân loại Học máy
Hai loại dữ liệu đầu vào:
| Loại dữ liệu | Đặc điểm | Ví dụ |
|---|---|---|
| Dữ liệu có nhãn | Được gắn kết với một nhãn hoặc giá trị đích cụ thể | Hình ảnh con ngựa được gán nhãn “Con ngựa” |
| Dữ liệu không có nhãn | Không được gán nhãn | Tập hợp hình ảnh các con vật chưa được phân loại |
Vai trò của dữ liệu có nhãn:
- Đóng vai trò rất quan trọng trong quá trình huấn luyện mô hình
- Cung cấp thông tin cần thiết cho mô hình để học và đưa ra dự đoán chính xác
- Việc có dữ liệu được gán nhãn đúng và đa dạng là yếu tố quyết định để xây dựng mô hình học máy hiệu quả
Hai phương pháp học máy cơ bản:
Học có giám sát (Supervised Learning)
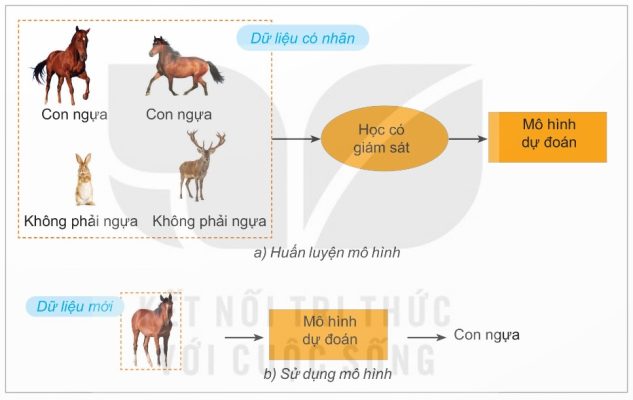
Định nghĩa: Học có giám sát là phương pháp học máy trong đó tập dữ liệu đầu vào là dữ liệu đã được gán nhãn.
Cơ chế hoạt động:
| Pha | Nội dung |
|---|---|
| Pha huấn luyện mô hình | Máy tính được “học” từ dữ liệu có nhãn, mô hình hóa mối quan hệ giữa dữ liệu đầu vào với đầu ra tương ứng |
| Pha sử dụng mô hình | Khi đưa dữ liệu mới vào, máy tính xác định các đặc trưng và đưa ra dự đoán dữ liệu đó thuộc loại nào |
Đặc điểm: Học có giám sát là phương pháp học máy được sử dụng rộng rãi nhất.
Ứng dụng:
- Xây dựng bộ lọc thư rác
- Nhận dạng hình ảnh
- Nhận dạng chữ viết tay
- Nhận dạng tiếng nói
Học không giám sát (Unsupervised Learning)
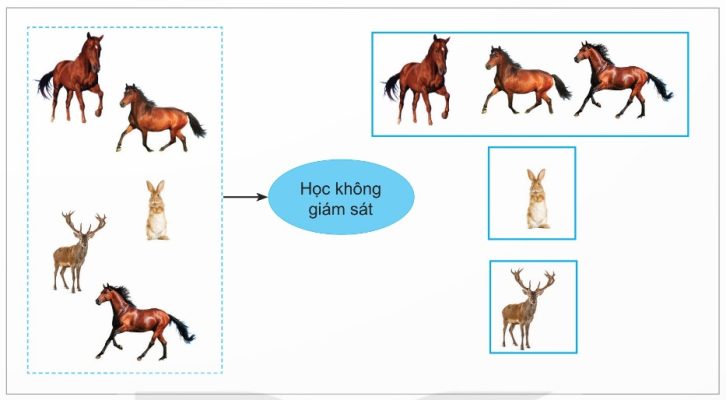
Định nghĩa: Học không giám sát là phương pháp học máy sử dụng dữ liệu không có nhãn.
Cơ chế hoạt động:
- Sử dụng thông tin về mối quan hệ tương tự hay khác biệt giữa các đối tượng
- Dựa trên xác suất đồng xuất hiện của các đối tượng hoặc các biến có trong dữ liệu
- Thực hiện việc mô hình hóa cấu trúc hoặc mô tả các thông tin ẩn chứa trong dữ liệu
Ứng dụng:
- Phân nhóm các con vật dựa trên hình ảnh
- Xác định các phân khúc khách hàng dựa trên lịch sử mua hàng
- Phát hiện bất thường trong các giao dịch thẻ tín dụng để xác định gian lận
- Xác định các chủ đề khác nhau trong một tập hợp các bài báo
Bảng so sánh hai phương pháp:
| Tiêu chí | Học có giám sát | Học không giám sát |
|---|---|---|
| Loại dữ liệu | Dữ liệu có nhãn | Dữ liệu không có nhãn |
| Mục tiêu | Phân loại dữ liệu mới vào các lớp đã biết | Phân cụm dữ liệu thành các nhóm |
| Kết quả | Dự đoán nhãn cho dữ liệu mới | Tìm ra cấu trúc ẩn trong dữ liệu |
| Mức độ sử dụng | Rộng rãi nhất | Ít hơn học có giám sát |
b) Vai trò của Học máy
Học máy có vai trò quan trọng trong nhiều công việc và ứng dụng thực tế. Nó hỗ trợ khai phá các loại dữ liệu đa dạng, có quy mô lớn, bao gồm cả các dữ liệu không ngừng thay đổi theo thời gian, để trích xuất được những thông tin và tri thức hữu ích.
Các ứng dụng cụ thể:
| Ứng dụng | Vai trò của Học máy |
|---|---|
| Lọc thư rác | Xây dựng mô hình phân loại thư dựa trên từ khóa, cấu trúc thư và nhiều yếu tố khác. Giảm thời gian và công sức của người dùng, cải thiện hiệu suất lọc thư theo thời gian bằng cách học hỏi từ dữ liệu và cập nhật mô hình |
| Chẩn đoán bệnh | Sử dụng dữ liệu về tình trạng sức khỏe, kết quả xét nghiệm và cơ sở dữ liệu bệnh lý để xây dựng mô hình chẩn đoán. Dự báo tình trạng sức khỏe và đề xuất phương án điều trị phù hợp. Học từ hàng ngàn lần chẩn đoán trước đó để giúp bác sĩ đưa ra quyết định chính xác và nhanh chóng hơn |
| Phân tích thị trường | Phân tích dữ liệu thị trường từ nhiều nguồn để xác định xu hướng, dự báo biến động giá cả, hỗ trợ hình thành chiến lược kinh doanh. Giúp người đầu tư và nhà kinh doanh hiểu rõ hơn về thị trường |
| Nhận dạng tiếng nói | Xây dựng các mô hình âm thanh để biểu diễn đặc trưng của tiếng nói, nhận dạng các biểu hiện âm thanh của từng đơn vị tiếng (phoneme), tạo ra biểu diễn số hóa của âm thanh. Cải thiện khả năng nhận dạng và phân biệt tiếng nói của những người nói khác nhau |
| Nhận dạng chữ viết | Xây dựng mô hình hình học để xác định hình dạng, kích thước, góc xoay của các ký tự trong hình ảnh chữ viết tay. Học sâu cho phép trích xuất các đặc trưng phức tạp, cải thiện đáng kể khả năng nhận dạng |
| Dịch tự động | Sử dụng dữ liệu về bản dịch và bản gốc trong các ngôn ngữ khác nhau để xây dựng mô hình dịch văn bản, tiếng nói. Giúp hạn chế rào cản ngôn ngữ trong giao tiếp, phát triển hợp tác và trao đổi thông tin |
Vai trò quan trọng của Học máy được thể hiện ở nhiều góc độ:
- Xử lý lượng lớn dữ liệu trong thời gian thực một cách nhanh chóng và hiệu quả
- Xác định các mẫu và xu hướng quan trọng có trong dữ liệu
- Tự động hóa các nhiệm vụ phức tạp mà trước đây cần sự can thiệp của con người
- Giúp các chuyên gia và nhà nghiên cứu từng bước xây dựng và bổ sung tri thức
- Khả năng không ngừng bổ sung dữ liệu và tự động cập nhật mô hình đã được huấn luyện
Tại sao Học máy không thể thiếu trong các ứng dụng có dữ liệu thay đổi theo thời gian?
Nhờ khả năng không ngừng bổ sung dữ liệu và tự động cập nhật mô hình, Học máy ngày càng có vai trò không thể thiếu trong các ứng dụng mà dữ liệu có quy mô và chủng loại đa dạng, không ngừng thay đổi theo thời gian, như:
- Sự xuất hiện các mẫu thư rác mới
- Các triệu chứng bệnh mới
- Các bản dịch ngôn ngữ mới

Thầy Phạm Thành Danh
(Người kiểm duyệt, ra đề)
Chức vụ: Trưởng ban biên soạn môn Tin Học THPT
Trình độ: Cử nhân Sư phạm Tin học, Chứng chỉ hạng II, Chứng chỉ Tin học, Ngoại ngữ B1
Kinh nghiệm: 8+ năm kinh nghiệm tại Trường THPT Thuận Hóa